Зачем это нужно
Распределение описывает случайную величину полностью, но часто громоздко. На практике хватает двух чисел: где в среднем лежат значения (математическое ожидание) и насколько они разбросаны (дисперсия). Так оценивают доходность и риск инвестиций, точность станка, выгодность игры или страховки, качество прогноза. В 9 классе мы научились считать эти величины по таблице. Теперь изучим их свойства: они позволяют находить характеристики сложных величин, не составляя громоздких таблиц.
Математическое ожидание
Для дискретной величины:
Это «центр тяжести» распределения: если поставить на числовую ось грузики массами в точках , ось уравновесится в точке . По закону больших чисел среднее арифметическое результатов многих независимых опытов приближается к .
Для равномерного распределения на ожидание — середина отрезка: .
Разобранный пример 1
Найдите ожидание числа очков на игральном кубике.
. Само значение 3,5 никогда не выпадает — ожидание не обязано быть возможным значением.
Свойства математического ожидания
- для постоянной.
- .
- — для любых величин, даже зависимых!
- — только для независимых.
Свойство 3 (линейность) — мощнейший инструмент: сложную величину раскладывают в сумму простых.
Разобранный пример 2
Найдите ожидание суммы очков на двух кубиках и числа успехов в схеме Бернулли.
- Сумма: — без таблицы из 36 исходов.
- Число успехов в испытаниях — сумма индикаторов , где при успехе в -м испытании. Каждый , поэтому .
Дисперсия
Дисперсия — ожидание квадрата отклонения от среднего:
Вторая формула обычно удобнее. Стандартное отклонение измеряется в тех же единицах, что и .
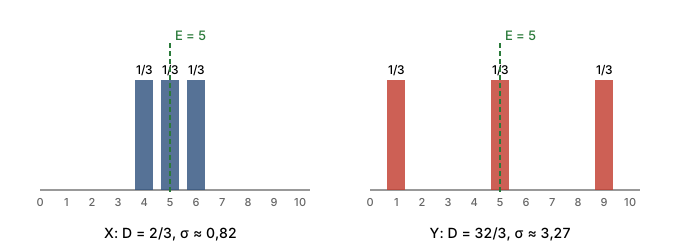
Разобранный пример 3
Найдите дисперсию числа очков на кубике.
; , .
Свойства дисперсии
- ; .
- — сдвиг не меняет разброс.
- , значит .
- — только для независимых величин.
Отсюда для биномиального распределения (сумма независимых индикаторов с ):
Разобранный пример 4
Известно , . Найдите ожидание и дисперсию .
, , . Обратите внимание: вычитание двойки дисперсию не изменило.
Разобранный пример 5
Тест из 100 вопросов, на каждый ученик наугад угадывает ответ с вероятностью 0,2. Каково среднее число угаданных и разброс?
, , . Обычно результат угадывания попадает в диапазон .
Разобранный пример 6
Игра: с вероятностью 0,1 выигрываете 10 рублей, иначе теряете 1 рубль. Найдите ожидание и дисперсию выигрыша.
- руб. — игра слегка выгодна.
- ; , — риск велик по сравнению со средним выигрышем.
Равномерное распределение
Для величины, равномерно распределённой на :
Например, время ожидания автобуса, который ходит каждые 10 минут, в среднем 5 минут, а минуты. Ошибка округления до целых равномерна на : в среднем ноль, .
Неравенство Чебышёва
Насколько далеко величина может уйти от среднего? Для любого распределения:
Отклониться на два стандартных отклонения и больше можно с вероятностью не выше , на три — не выше . Оценка грубая, зато работает всегда; для нормального распределения вероятности намного меньше.
Почему среднее многих опытов точнее
Пусть — независимые измерения с дисперсией . Их среднее имеет то же ожидание, а дисперсию . Значит, разброс среднего уменьшается в раз. Чтобы вдвое повысить точность, нужно в четыре раза больше измерений. Это основа всех статистических опросов и физических экспериментов.
Немного истории
Понятие ожидания появилось в переписке Паскаля и Ферма (1654) о справедливом разделе ставки в прерванной игре. Христиан Гюйгенс в книге «О расчётах в азартной игре» (1657) назвал его «ценой шанса». Дисперсию и знаменитое неравенство ввёл Пафнутий Львович Чебышёв (1867), доказав с их помощью закон больших чисел в общем виде.
Типичные ошибки
- Считать, что для зависимых величин.
- Писать вместо , и вместо суммы.
- Путать и .
- Получать отрицательную дисперсию — верный знак ошибки в вычислениях.
Что дальше
- Нормальное распределение и стандартизация — нормальное распределение и правило трёх сигм.
- Выборка и статистический вывод — выборка и статистический вывод.